 优推编辑部
从一个卖伞的故事说起
先给大家讲个有趣的故事。
在街角有一家小杂货店,老板专门卖雨伞。一天,他想预测明天该备多少伞,于是翻出了过去半年的销售记录,逐条查看:哪天卖得多,哪天少。经过一番分析,他得出一个平均值,决定按每天七八把的销量来备货。
结果呢?接连几天下大雨,伞居然卖光了!老板心里很不解:明明有数据,怎么就没算准呢?
其实问题不在于他的计算,而是他只看了“卖出多少”这一个层面,却忽略了“为什么卖这么多”。雨伞的销量与天气是密不可分的,而天气预报早就提示明天有雨,这个信息他虽然知道,却没有考虑进去。
这个小故事揭示了一个时序预测的普遍原则:一条数据的未来,不仅取决于它的历史,还受许多外部因素的影响。
比如,雨伞的销量跟天气有关,奶茶店的销量受节假日影响,写字楼的用电量与气温相关,商场的人流量则与促销活动息息相关。这些外部因素可能在你的数据中已有记录,或者你可能提前就知道一部分信息,比如天气预报或促销信息。但是很多人做预测时,手里握着这些信息,却不知道如何有效利用,最后只能用“看历史、猜未来”的方式。
这就是预测不精准的常见原因之一:未能充分利用所有信息。
那么,有没有办法把这些“额外的信息”有效地输入到预测模型中呢?当然有,这个方法称为协变量(Covariate)。TimechoAI平台对此提供了强大的支持,只需在调用时添加两个额外参数,就能将天气预报、促销日历、节假日安排等信息传递给模型。
接下来,我将详细说明:协变量是什么,如何在TimechoAI中使用它,以及如何进行完整的对比实验,具体的功能在实际业务中又能带来什么帮助。其中还有可运行的代码,让你可以轻松上手。
什么是协变量?简单易懂的解释
先给个简单的定义,但我不会用太复杂的术语。
协变量是指在预测的主数据之外,所有可能对其产生影响的时间序列数据。
想象一下,你需要预测一家奶茶店未来一周的销售额。这里分为几个角色:
- 销售额本身:这条数据按天记录,就是我们的目标变量(Target),它是关键。
- 每天的气温:天气热时,顾客会买得更多。
- 每天是否为周末:周末的顾客量通常更多。
- 每天是否有促销活动:促销对销量的影响更是显著。
虽然这三项不是主角,但它们都会在旁边影响主角的走向,这就是协变量。
通过图示,我们能看到协变量不仅影响历史数据,还会继续影响未来。明天的气温、是否是周末、是否有活动,这些都会直接影响明天的销量。因此,协变量绝对不是可有可无的,它们是预测公式中不可或缺的一部分。
协变量的分类
进一步来看,协变量可以按“时间上的位置”分为两类,这一分类很重要,因为在TimechoAI中,它们对应不同的参数设置。
第一类:历史协变量(History Covariates)。
这类数据指的是过去的辅助数据。比如过去一个月的每日气温和客流量。这些数据是已经发生的事实,能够帮助模型理解过去销售波动的原因——例如,过去销量高的原因可能是由于连续的晴天和周末促销。如果模型搞清楚了这个“为什么”,对规律的理解就会更深刻。
第二类:未来协变量(Future Covariates)。
这类数据指的是未来时间段的已知信息。听起来可能有些复杂,但其实非常常见:
- 天气预报:明天的气温,气象台已经给出预测值。
- 日历信息:知道明天是周六,后天是节假日。
- 活动排期:知道下周三会有大促销。
- 库存计划:知道下个月要备多少货。
它们的共同点是:虽然事情还未发生,但我们已经掌握了相关信息。这种未来信息对于预测的价值往往超过历史协变量——毕竟,预测的目的是为了了解未来,提前掌握未来的影响因素,预测的准确性就会提高。
简单来说,历史协变量帮助我们解释过去,而未来协变量则为我们指引未来。
为什么协变量能够提升预测精度
可能有人会问:大模型不都说自己很聪明吗?难道只看目标变量的历史数据就可以了吗?
其实在大部分情况下,仅仅依靠历史数据确实能做出个大概的预测。因为数据本身会有惯性——今天如果卖了100杯,明天大概率也不会差太远。但仅靠历史数据应对外部因素的影响,就很容易出错:
- 如果不考虑天气信息,模型会认为“明天降温”这条信息不存在,随便给个普通的预测值。结果寒潮一来,销量翻倍,预测偏差就很大。
- 如果不考虑促销信息,模型会将以往的促销日销量当成随机波动,最后导致预测失真。
通过一个简单的例子来说明这个问题。假设某店的日销量长期在200上下波动,历史上有几次促销期间冲到了500。如果你要预测“下周三”的销量,模型会查看历史数据,发现周围的销量都在180到220之间,于是预测200。而实际上下周三是促销日,真实销量却是480——这个预测误差直接达到280,误差率超100%。不过如果模型事先知道“下周三是促销”,它就能学会“促销日的销量规律”,给出的预测可能是450上下,误差瞬间降到30以内。
你看,同一个模型,信息更多,预测质量完全不同。信息的充分与否,直接影响预测的精度,这在时序预测里几乎是个公理。
所以说,很多人的预测“看着做了,却总差一截”,原因在于输入信息不全面。如果让一个只看历史的模型去猜测一个受外部因素影响的序列,它只能输出一个平均值,而业务上才最需要的,就是那些“关键时刻”的准确预测。
而有了协变量后,模型就明白了“哦,原来那些尖峰是因为促销”,它就会学会促销与销量之间的关系,等到下次预测时,你告诉它“下周三有促销”,它就知道要调整预测值了。
因此,协变量带来的精度提升通常集中在那些外部影响大的关键日子——而这些日子在业务上正是最有价值的:备货、排班、库存都需要根据这些天的数据来做决定。
TimechoAI在这方面的好处在于:它将“使用协变量”的门槛降低到了只需传递两个参数的程度。传统的开发流程中,光是将外部特征与目标序列对齐、输入模型、处理缺失数据,就可能耗费工程师好几天。而在TimechoAI,这一切都变得简单快捷。
TimechoAI中的协变量:两个参数与两条规则
前面的概念阐述完了,接下来聊聊实际操作。在TimechoAI的Python SDK中,协变量的对应方法是forecast(),需要传入的两个参数是:
history_covs:历史协变量,类型为pandas DataFrame。future_covs:未来协变量,类型同样为pandas DataFrame。
此外,还有两个参数需要配合使用:
time_col:指定时间列。设置后,所有传入的数据(目标变量和协变量)都需要包含时间列,这样服务端才能按照时间对齐数据。auto_adapt:自动数据适配,默认为True。如果数据有一些小问题,比如频率不一致或长度差异,它会自动进行一些调整,新手建议保持默认。
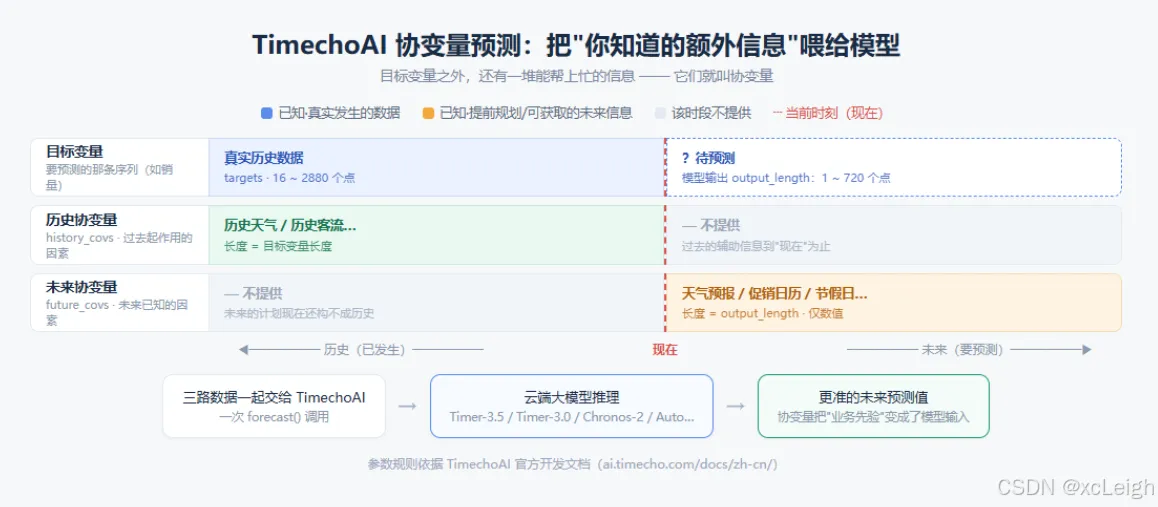
配图中展示的“历史 / 现在 / 未来”时间轴图,就是这两个参数在时间线上的关系:
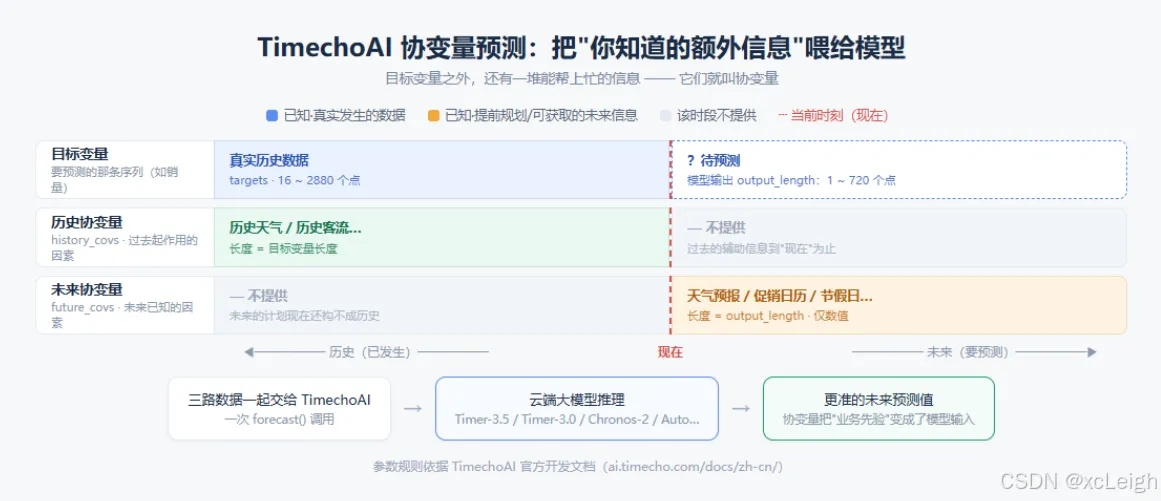
接下来是两条必须牢记的规则,传错参数就会报错:
| 参数 | 长度规则 | 数据要求 |
|---|---|---|
history_covs |
长度需与目标变量(targets)一致。 |
与历史数据逐一对应。 |
future_covs |
长度需等于output_length(预测长度)。 |
仅限数值型数据。 |
这两条规则的含义是:
规则一:历史协变量长度需与目标变量一致。你提供240个点的历史销量,那历史协变量也需有240个点——第1天的气温对应第1天的销量,第240天的气温对应第240天的销量,必须一一对应,缺一不可。
规则二:未来协变量的长度需等于预测长度。若你要预测未来14天(output_length=14),那么未来协变量也得有14天的数据——从历史数据下一天开始,到预测结束的那一天为止。还有注意,数据类型必须是数值型:气温、湿度、节假日标志(1/0)、促销力度(折扣数)都可以,但像“周一/周二/周三”这种文字需要先转换为数字,这个细节后面会再说。
掌握了这两条规则,协变量预测就已经成功了一大半,接下来就是动手跑代码的环节。
实战准备:环境与数据
开始之前,先把环境准备好。总共需要三样东西:
第一,Python环境。版本要求是3.10至3.13,确保不要使用过老的版本。
第二,官方SDK。只需要输入一行命令:
pip install timecho-ai
第三,API密钥。去官网 https://ai.timecho.com 注册账号,进入控制台创建一个密钥,后面使用客户端时用到。
在数据方面,官方文档已经提供了一份协变量示例数据 sample_cov.csv,你可以直接通过网址读取,不需要自己寻找。这份数据的结构如下:每行对应一个时间点,共有四列——
time:时间列。target:目标变量,也就是要预测的那条数据。temperature:气温,典型的协变量。humidity:湿度,另一项协变量。
用这份数据练手再合适不过:目标变量是主角,而气温和湿度则是外部影响因素,完美展示协变量的使用方法。等你自己上手后,把这些列替换成你业务中的真实数据,比如将temperature换成“客流量”,humidity换成“促销标志”,方法是一样的。
值得一提的是,现实业务中,很多公司早已积累了丰富的协变量数据:销售系统中的促销记录、运营排期表中的活动计划、行政日历中的节假日安排、运维监控中的历史负载等。这些数据往往分布在不同的系统中,格式各异。做协变量预测前的准备工作,实际上就是把这些数据整理到一张表中——一列时间、一列目标变量、若干列协变量,每行代表一个时间点,跟sample_cov.csv的结构一致。整理这一步,Excel就能轻松完成,pandas也行,技术门槛几乎为零。换句话说,协变量预测最大的挑战在于,你能否认真记录下业务中那些“影响因素”并将其转化为数据。从现在开始,留意记录,三个月后你就会成为公司数据最丰富的人。
实战第一回合:不加协变量,先跑个基准
进行对比实验有个原则:先跑基准,再进行改动。否则,很难分清协变量究竟是帮了忙还是反而成了障碍。
基准版本就是最基础的预测,仅依靠目标变量,代码不长:
import pandas as pd

from timecho_ai import TimechoAIClient


# 创建客户端(需替换为您的 API Key)

client = TimechoAIClient(api_key="your_timecho-ai_api_key")


# 任务定义:输入 16 个点,预测 8 个点

INPUT_LENGTH = 16

OUTPUT_LENGTH = 8


# 读取示例数据

raw_df = pd.read_csv("https://ai.timecho.com/data/sample_cov.csv")


target = raw_df[["time", "target"]][:INPUT_LENGTH]


# 不带协变量,直接预测

result = client.forecast(

    targets=target,

    output_length=OUTPUT_LENGTH

)


print(result[0])