 优推编辑部
大家有没有这样的经历:在和朋友语音聊天时,刚说完一段话,对方却迟迟没有回应,瞬间感觉气氛有点冷。其实这就是语音对话的挑战之一。与打字聊天不同,语音交互要求系统能够迅速响应,不然人们就会怀疑连接是不是有问题。对于语音助手来说,理解何时听、何时答,以及如何根据用户的意图调整状态,都是极其重要的。
我最近关注的一款产品是2026年发布的Gemini 3.8 Live系列,它结合了实时视觉、语音互动和后台工具执行。这让我想到了很多在开发实时对话系统时需要考虑的细节,而下面我们就来聊聊其中的一些关键环节。
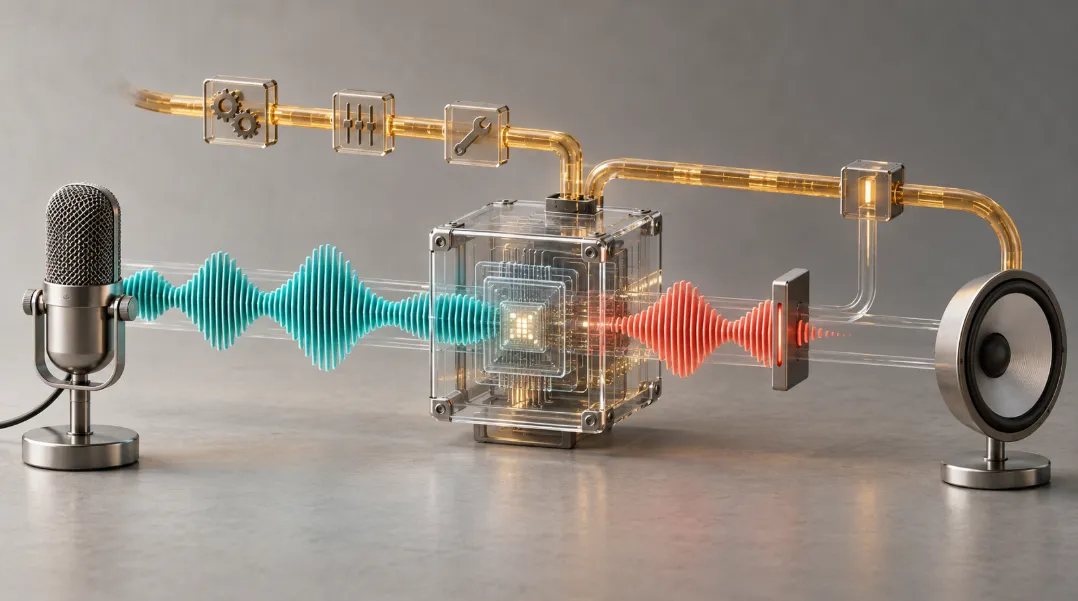
我们先来看看实现方式。传统的语音交互系统通常会先把声音转换成文字,再通过语言模型生成回答,最后将回答合成语音。这样的流程听起来很直观,分为三个步骤:语音识别(ASR)、语言模型(LLM)和文本转语音(TTS)。但是,分段处理也带来了不少限制,比如语音中的情感、停顿或语气可能会在转化过程中丢失。
而原生语音模型则更进一步,它直接处理音频信号,能够在内部完成声音与语义的转换,有些甚至可以直接输出音频。这样减少了对文本的依赖,提升了理解语气和自然对话的能力。不过,尽管流程更简单,依旧需要关注各种外部因素,比如麦克风质量、网络延迟等等。
不同的实现方式各有优缺点,选择的关键应该在于使用场景和用户体验,而不是单纯的技术名称。比如,如果你的应用场景需要精确的语音识别和表达,那么传统的流水线模式可能更适合。但如果你追求的是自然流畅的交流体验,原生语音模型可能更具优势。
接下来,谈谈对话的速度。语音系统的延迟主要来自几个环节:声音采集、判断用户是否说完、上传、模型处理和播放等。这里很多人低估了判断用户何时停止说话的环节。实际上,用户在系统识别到他们停止说话之前,系统往往会等待一段时间,以免误判。
为了解决这个问题,语音活动检测(VAD)就是关键。它可以根据音频特征判断语音的开始与结束,同时结合语义进行更准确的判断。我在使用OpenAI的VAD文档时,发现不同服务的事件与参数并不能直接互换,这就是实践中的挑战。
实际上,延迟的记录和管理可以通过简单的表格来实现,观察不同时间节点的表现,能帮我们理解系统的运作效率。比如,从用户语音被采集到系统确认回合结束的时间,以及第一段回答音频的到达时间,这些都是需要关注的重点。
然后,我们聊聊插话的处理。在系统说话时用户想要打断,这种情况在技术上称为“barge-in”。这个过程并不简单——需要及时识别新的输入,停止旧有回答的生成,并确保不会播放过时的信息。想象一下,如果系统认为用户已经听完了十句话,而实际上用户只听了前两句,这就会造成信息重复或遗漏。
而且,处理插话时还要小心网络延迟,旧的音频包可能在新指令之后才到达。这时给每个回答加上版本标识是个不错的办法,确保只有当前的回答被接受。这样一来,即使有延迟,旧数据也不会干扰到新的对话。
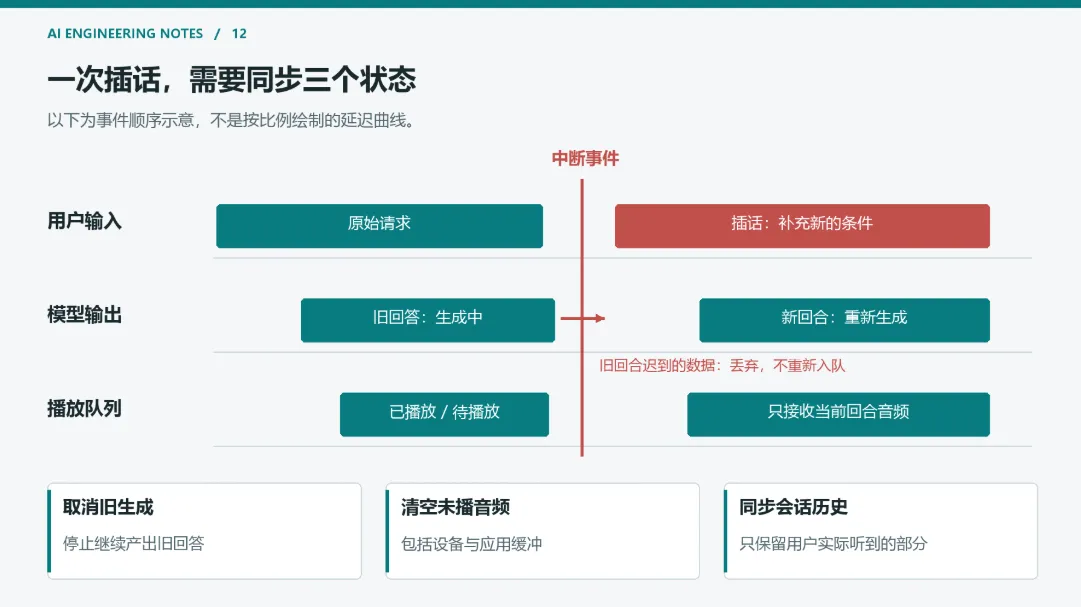
为了更好地测试语音系统的表现,我建议从简单的对话场景入手,观察系统是否能稳定处理不同情况,比如用户中途改口、长时间停顿等。在实际操作中,记录误打断次数、用户等待时间和工具结果的有效性都是非常必要的。
最后,值得一提的是,成功的语音助手应该让人感受到它知道何时该听、何时该答。虽然自然流畅的声音会加分,但回合的清晰度、状态的一致性和动作的可靠性才是最基本的要素。理解这些细节后,再看“边听边答”的演示,你就会更容易分辨出它是展示模型能力,还是一条真正能够长期工作的系统链路。