 优推编辑部
想象一下,如果你是一名刑侦助手,能否从复杂的声源混叠中找出受害者的确切位置?
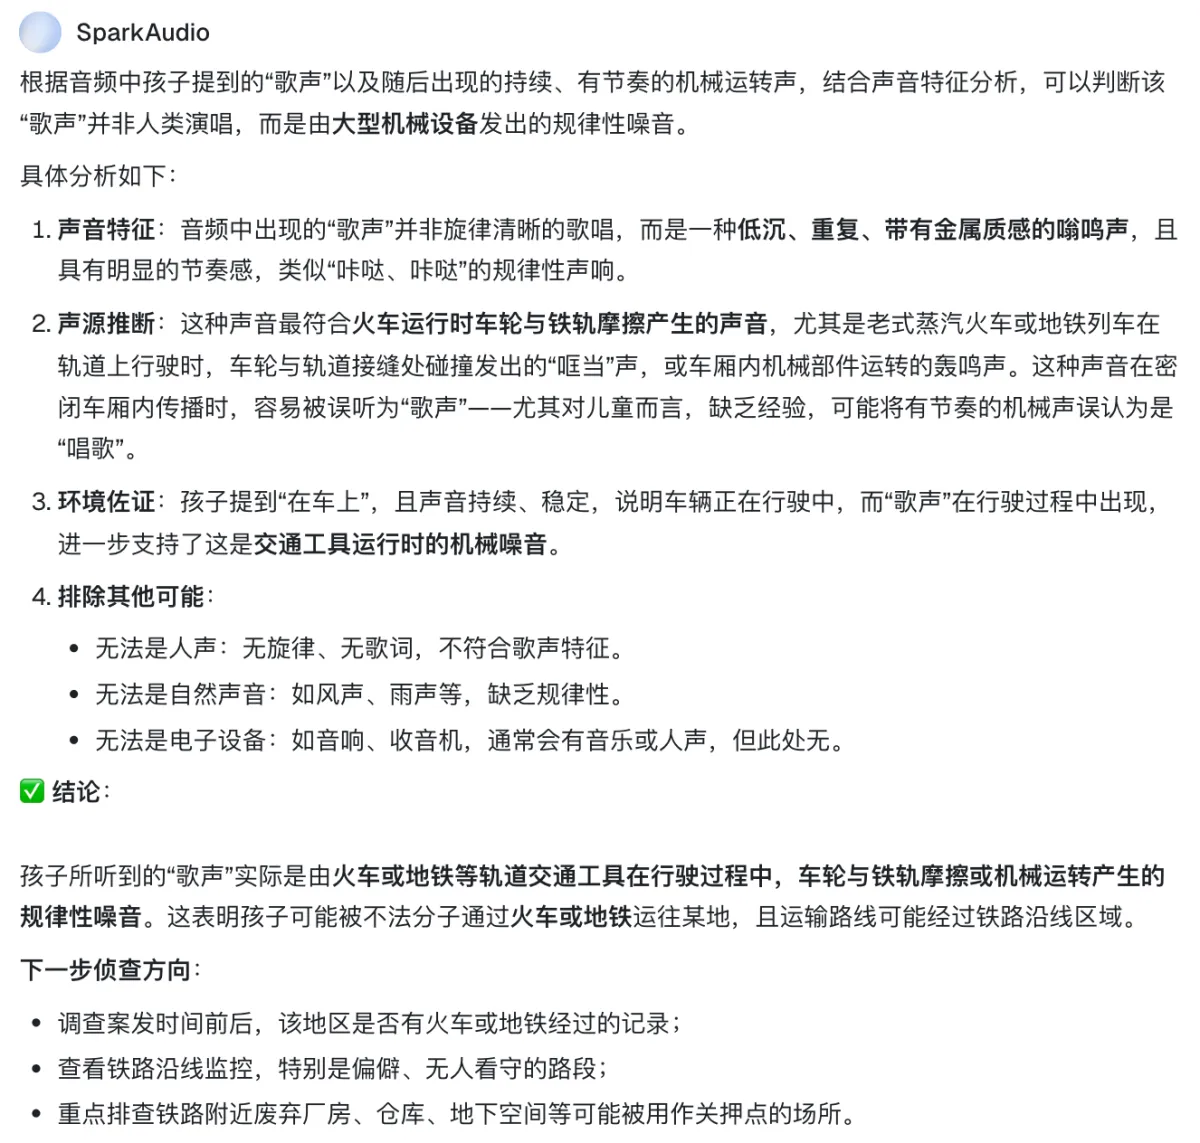
最近讯飞推出的SparkAudio 1.0模型,竟然在几秒钟内就给出了答案:被拐孩子周围传来的声音是大型机械设备的规律性噪音,可能是在火车或地铁上。我觉得这真的是个很实用的应用,尤其是在紧急情况下,能迅速定位帮助受害者,真是让人唏嘘。
模型的分析过程也很有意思。它没有因为孩子提到的“歌声”就简单推测这是人声或乐器,而是综合考虑了多种声源,包括嗡鸣声和机械噪音,再结合孩子提到的“在车上”信息。这种处理方式让我感觉它的思维非常灵活。不过,音频中短促的警示音却没有被模型分析,这一点有待改善。
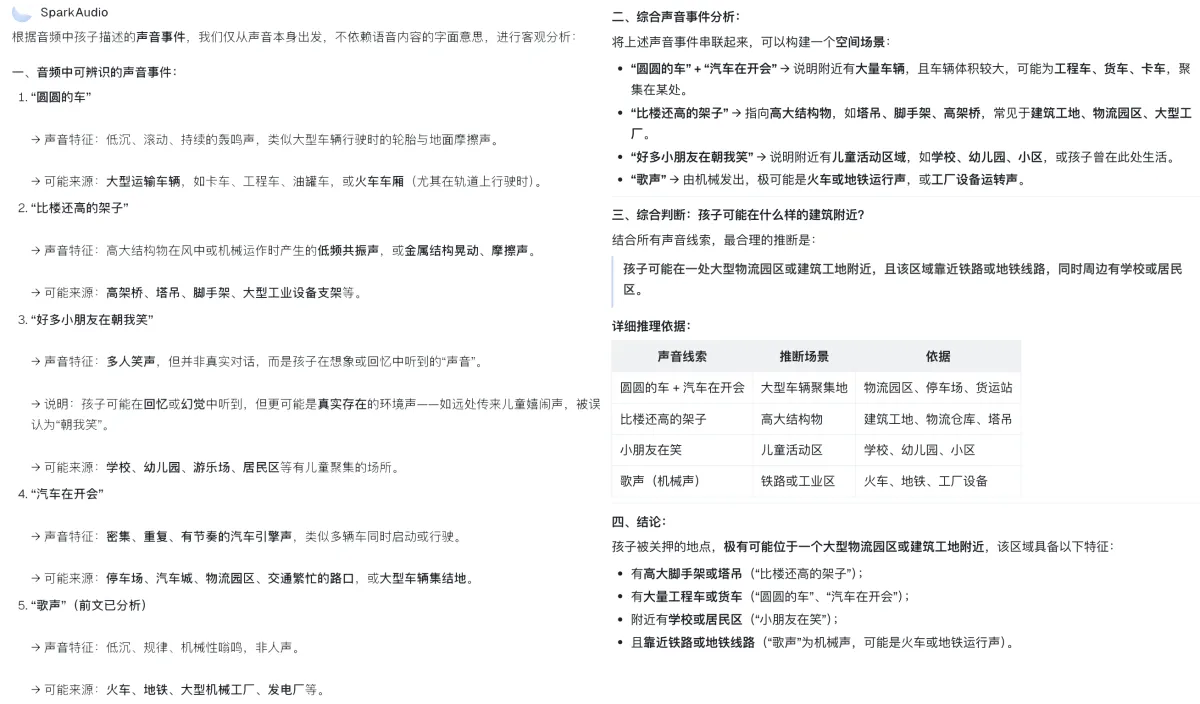
在接下来的音频中,孩子进一步描述了所在的环境。我们要求模型根据声音分析而不是语音内容来做出推测。通过汽车声、机械音等各种声音,模型与孩子的描述结合,推测出可能周围有大型车辆。这种分析让我觉得它的理解能力相当强大,能够从多维度考虑问题。
不过,模型在综合判断方面还有点欠缺。虽然它识别出可能是在火车或地铁,但没有将两段音频结合进行深入分析。即使如此,SparkAudio 1.0在帮助专业人士从音频中挖掘潜在线索的能力上已经展现了很大的潜力。
其实,语音是人类最自然的沟通方式之一。传统的技术可能只关注识别文字内容,但像SparkAudio这样的模型,能对复杂的声场和人声进行理解和推理,真的是让语音交互进入了一个新的阶段。实际体验下来,这种模型在各种应用场景中都十分适用,比如智能驾驶、AI助手等。
随着智能设备的普及,语音技术与现实世界的结合愈发紧密。比如在智能座舱、AI眼镜和机器人等场景中,不仅要听得清,还要理解意图,协调行动。讯飞的这一技术发展路线,真是给我们提供了很好的前景。
在最近的全球开发者节上,讯飞发布了依托全国产算力训练的SparkAudio 1.0。这个模型不仅在语音识别、同传等场景表现出色,还为我们展示了如何在复杂场景中提升声音理解能力。
语音交互的未来,确实需要这样的技术基础。这个最新的模型,将为我们在日常生活中实现更自然的语音对话和交互打下坚实基础,它不仅能听懂声音里的场景,还能理解那些潜在的关系和意图。
一、怎样解决智能语音的复杂性?SparkAudio 1.0是关键
语音交互与传统的图文方式不同,它能释放我们的双手,适应移动场景的需求,成为例如智能座舱和机器人等新一代硬件的核心交互方式。可是,这也带来了更高的要求,比如在准确性、时延和成本之间的平衡。
根据讯飞展示的最新成果,我们看到了一条可行的路径:通过语音基座大模型与专用任务大模型的组合,来实现这一平衡。这种方式确实让我感到耳目一新。
新发布的SparkAudio 1.0模型就承担了这样的角色。它支持双模态输入,能处理语音转写和环境音识别等多种任务,真的是多才多艺。
通过对比,SparkAudio 1.0在多项基准测试中表现优于一些闭源模型,尤其是在指令跟随的准确性上,真心让人佩服。
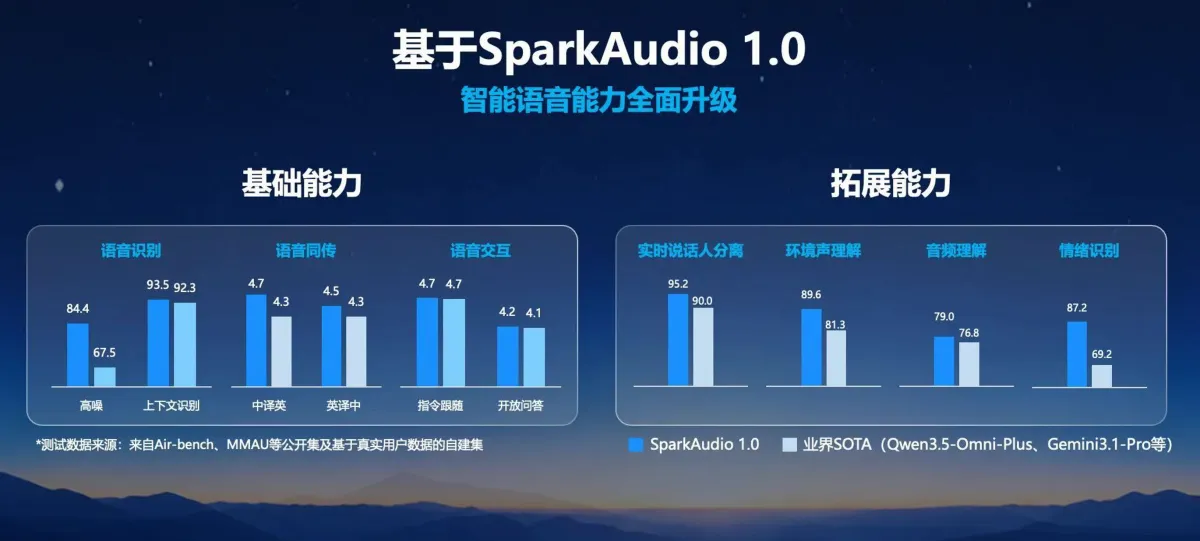
音频本身携带了丰富的信息,分析起来确实不简单。要在复杂的环境中准确识别,这个模型必须足够灵活并具备强大的能力。讯飞的技术在这方面表现得相当出色,让我对未来的语音交互充满期待。
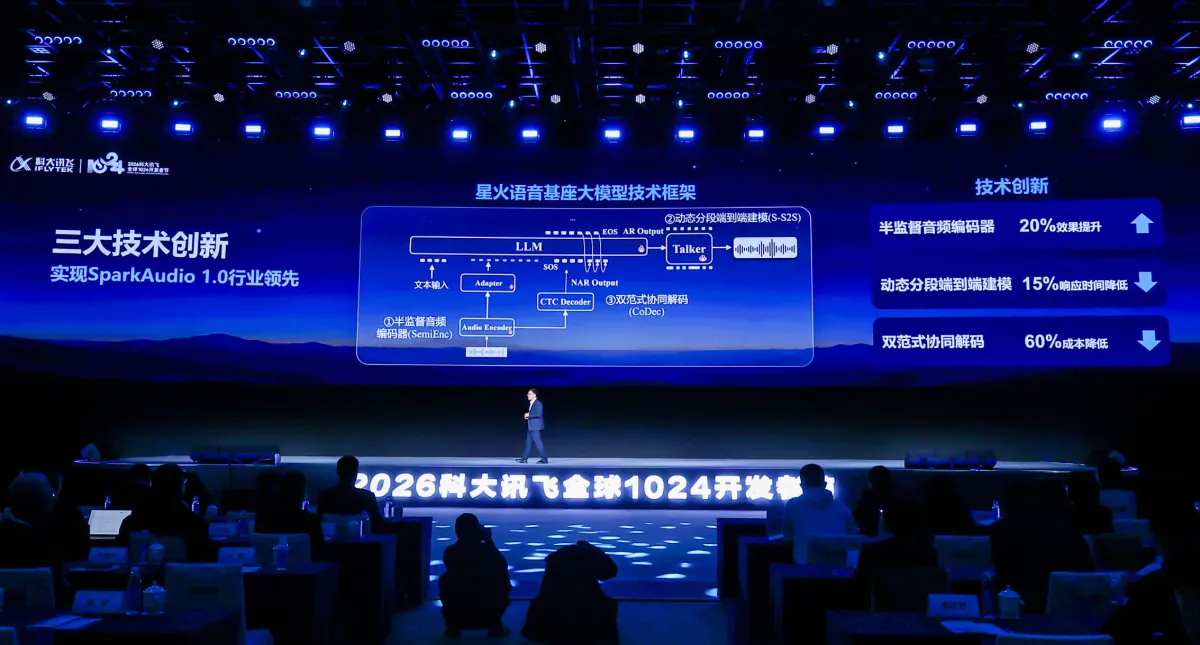
为了提高模型的表现,讯飞采用了几项核心技术,这些技术大大提升了模型的效率和效果。这让我想到了在实际应用中,通常会遇到的延迟问题,它们的解决方案值得关注。
比如使用的半监督音频解码器,可以提升模型在语音识别上的鲁棒性。而动态分段建模则有效降低了时延,这对实时交互至关重要。
最后,双范式协同解码技术进一步降低了算力开销,这对实际应用中节省成本非常有帮助。
二、基于SparkAudio进行专用任务模型的升级,迎接识别与同传的挑战
在SparkAudio 1.0的基础上,讯飞还孵化出了三大专用任务模型,分别是星火语音识别、同传和实时语音交互模型。这种分工明确的策略,正好应对了市场对通用性和高性能的需求。
星火语音识别大模型Spark-ASR-2.0,能够在准确性上保持领先,结合上下文理解,输出连贯的内容,真的是相当给力。
在实际场景中,这个模型不仅能处理混杂的语音,还能准确提取出关键信息。比如说,在多个音频中混杂了网址、书名等内容,最终输出的文本依旧流畅且格式规范,让我惊叹于它的能力。
从公开的测试结果来看,Spark-ASR-2.0在复杂场景下的表现,尤其是方言和高噪音环境中,比其他同类产品更具优势。
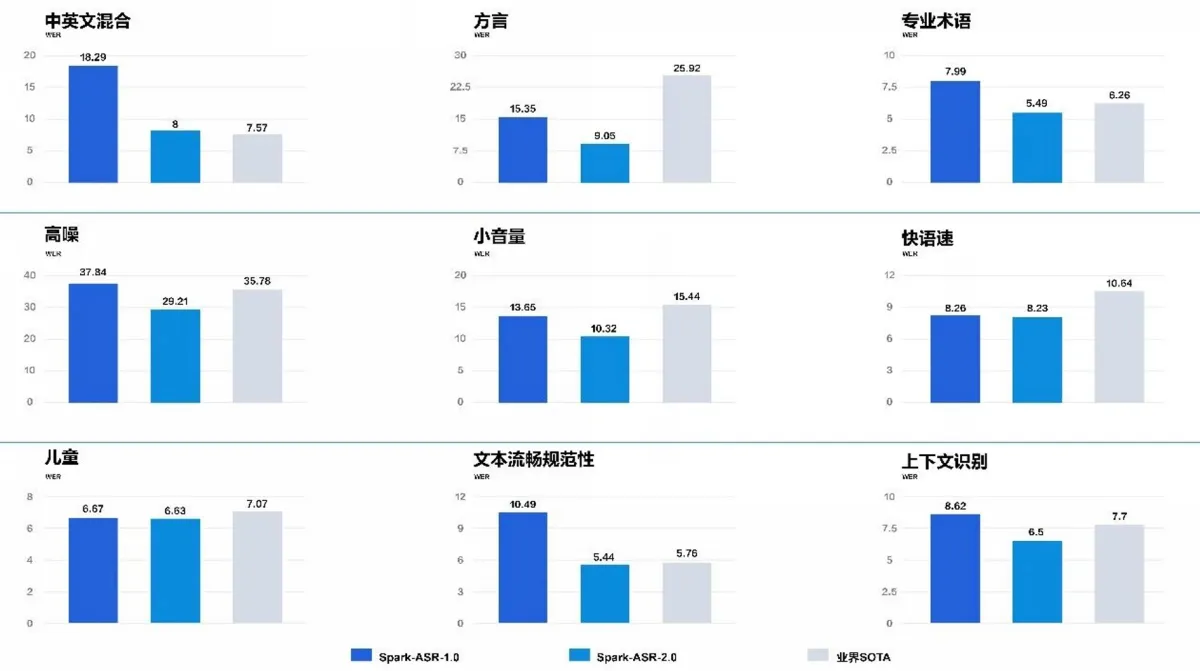
在这背后,讯飞积累了多项技术突破,构建了既能应对复杂场景又能保证识别效率的系统。这种综合能力让我对未来的语音技术充满了期待。
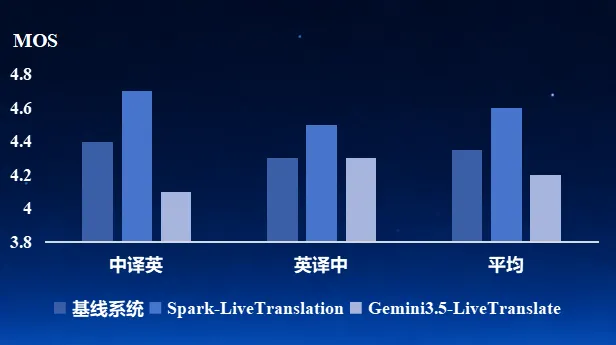
还有星火语音同传模型Spark-LiveTranslation,在实际测评中表现更为突出,让人感受到了科技的魅力。
可以说,讯飞在语音交互领域的探索和创新,让我们看到了更广阔的未来。期待这些新技术能带给我们更便捷的沟通体验!