 优推编辑部
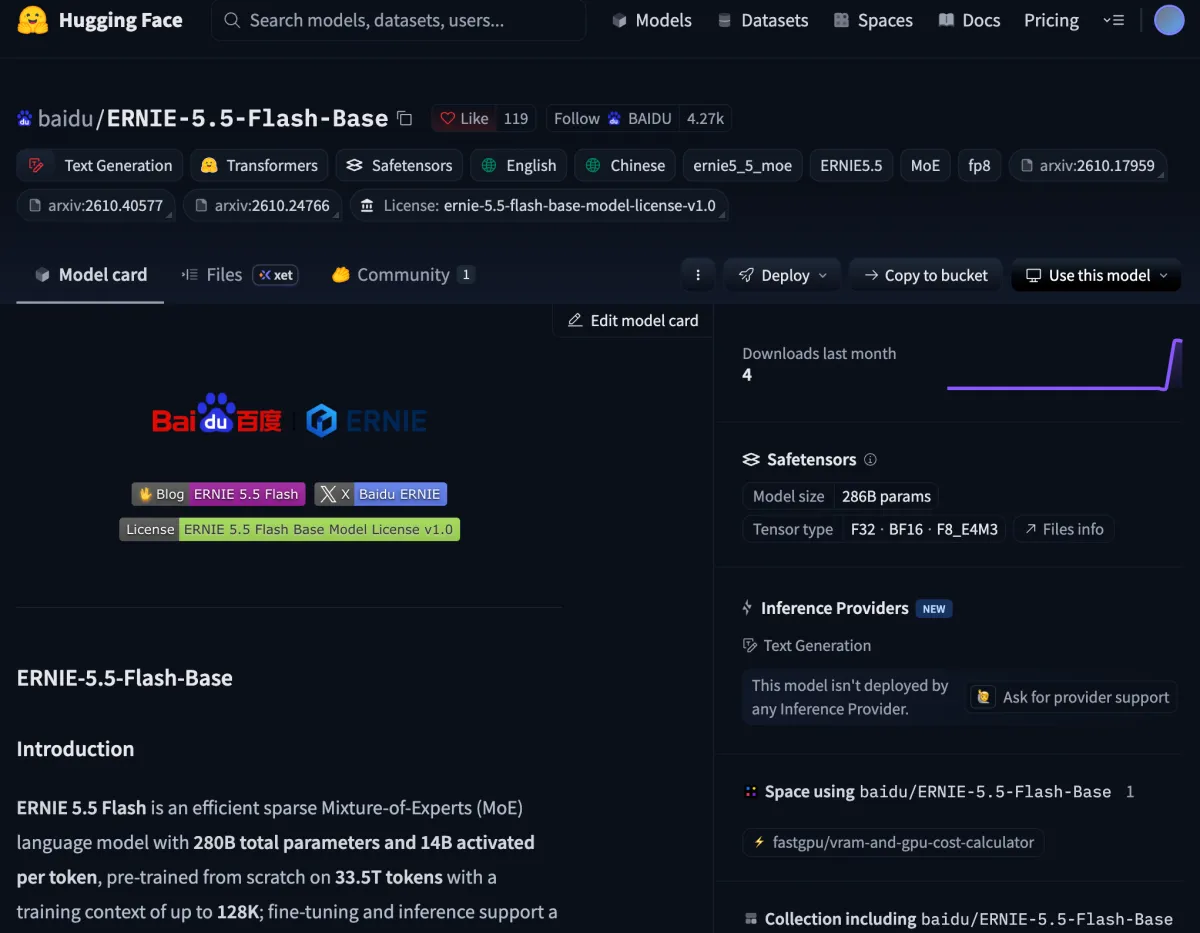
HF BF16: 链接
技术博客:链接
vLLM 插件: 链接
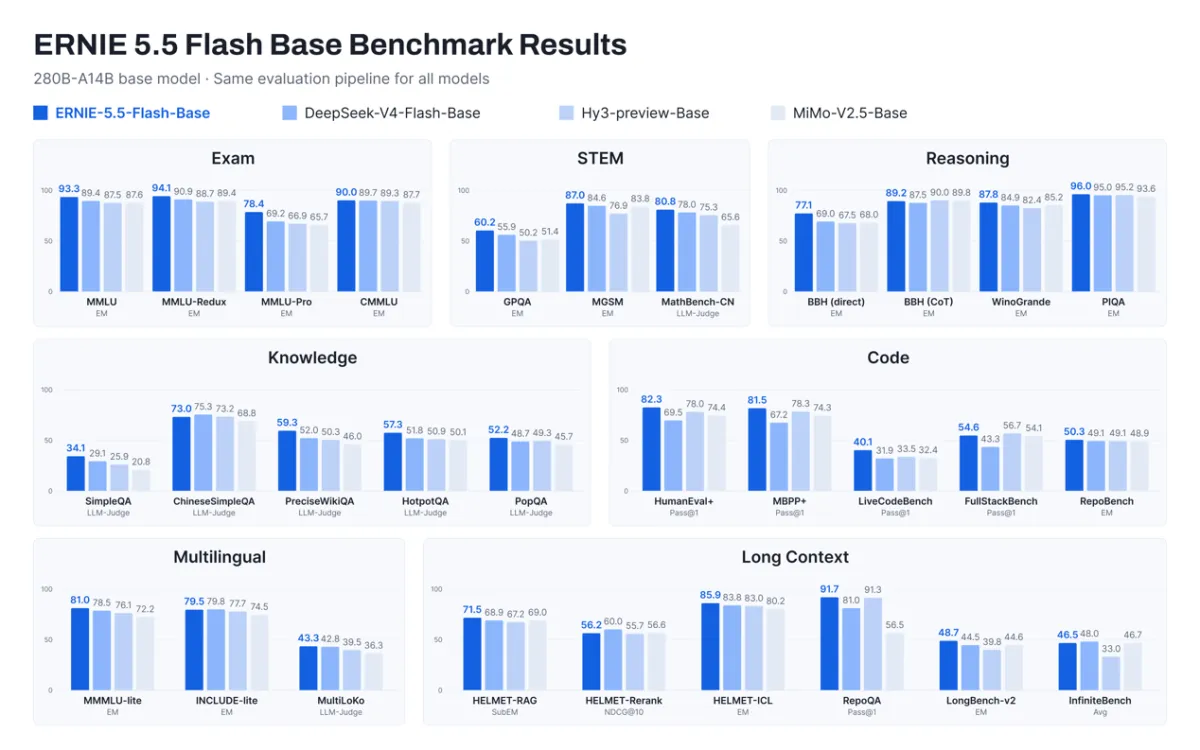
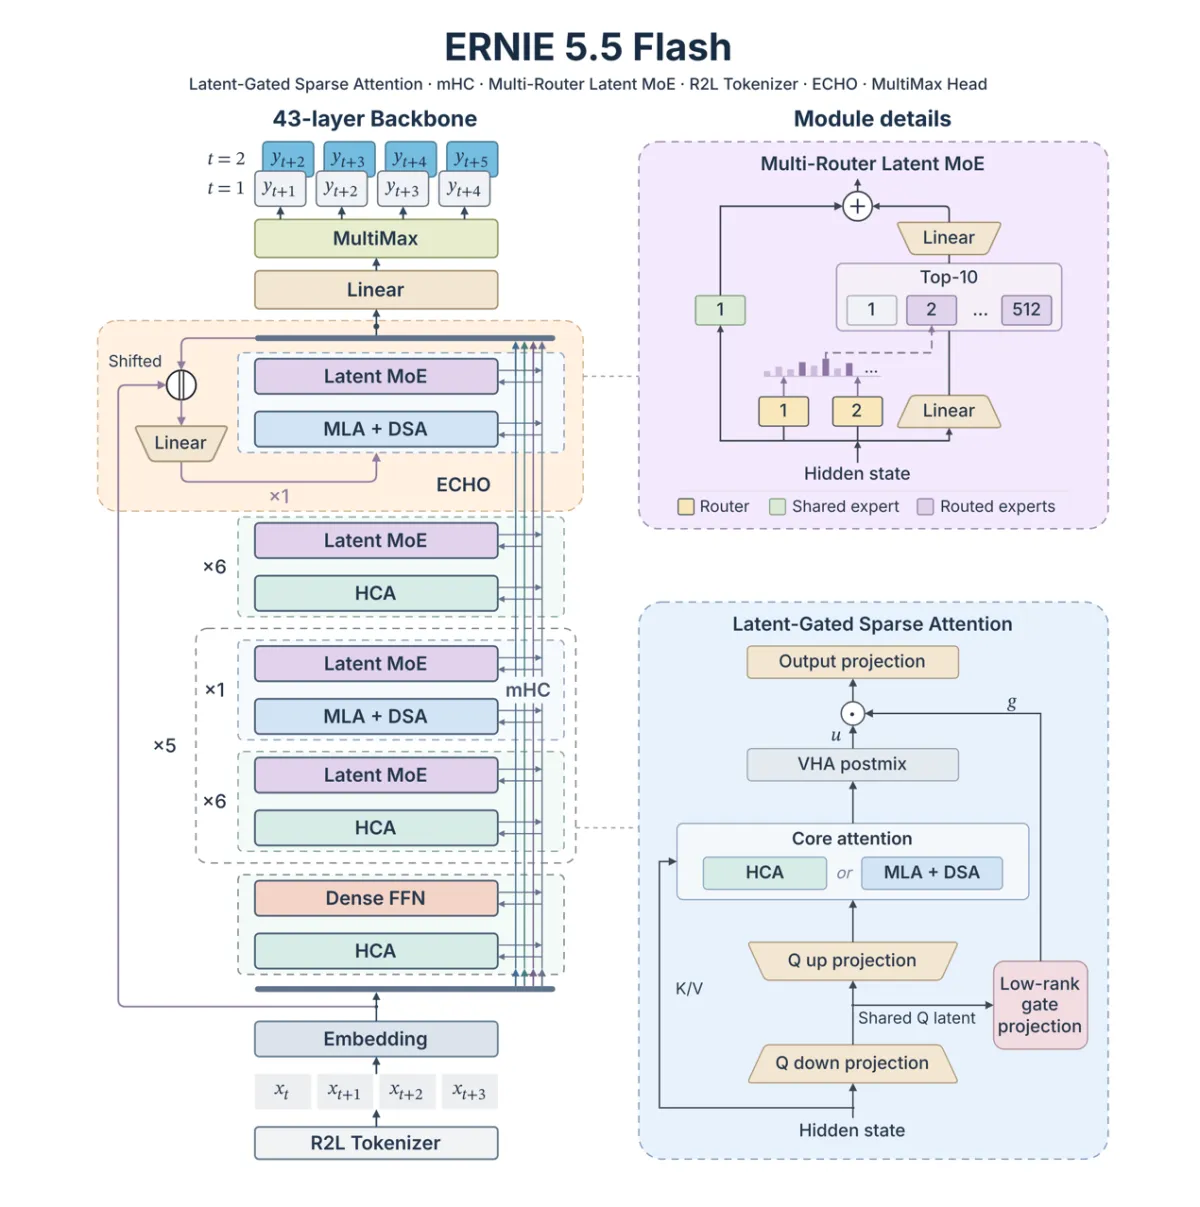
SGLang Cookbook:链接 一、同尺寸SOTA的背后,系统合力的成果 文心5.5 Flash Base在基准测试中取得了同尺寸SOTA的佳绩,尤其是在推理、代码生成和学科能力上的表现十分突出。这得益于它在预训练阶段采用了“重工业”式的策略。 这款模型总参数为280B,使用了稀疏MoE架构,允许较大的模型容量。每个token激活14B参数,这样就能有效控制计算成本。模型内部共有43层Transformer,隐藏层大小为4096,并设有64个注意力头。这样的设计充分利用了计算资源,能够吸收更多的专业知识和能力。 在算法方面,文心5.5 Flash Base对注意力机制进行了重要改进。它将HCA(重度压缩注意力)和MLA(多头潜在注意力)结合起来,形成了一种混合稀疏注意力机制。这种设计让不同层有针对性地处理历史信息,降低KV Cache的开销,同时保持了准确的检索能力。 预训练过程中,文心采用了Muon优化器和FP8混合精度,训练上下文逐步扩展至128K。发布时提供的是预训练的Checkpoint,开发者可以在此基础上进行领域适配、微调和推理强化。 在33.5T tokens的预训练中,文心覆盖了广泛的领域和语言,特别注重网页、代码和长文数据的构建。经过精细的数据处理,模型对这些数据的学习信号密度得以提升。 这三类数据分别促进了模型在知识覆盖、代码能力和长上下文理解上的表现。尤其是代码和长程依赖能力的构建,往往需要扎实的预训练基础,后期的补充数据难以完全弥补。 在基础设施层面,文心还对分布式Muon优化器进行了改进,推出了针对大头维度的注意力算子FlashMask-4,提升了大规模训练中的通信和计算效率。 可以说,文心5.5 Flash Base的同尺寸SOTA成绩正是模型架构创新与数据和基础设施优化协同作用的结果。基础越扎实,后续的微调和强化学习就越有空间。 二、将“效率”贯穿于预训练过程,三处关键改造解析 文心5.5 Flash Base在技术上实现了对“效率”的深度挖掘。在模型处理历史信息、调用专家能力和预测未来token的过程中,它采用了一系列创新。 那么,这些改进具体体现在哪些方面呢? 首先是混合稀疏注意力机制,它重新定义了模型对历史信息的访问方式。通过37层的重度压缩注意力和6层多头潜在注意力的合理搭配,不同层访问历史信息的方式得到了优化。 其次是Multi-Router Latent MoE的引入,多个路由器共同为专家打分,从而提高了专家选择的稳健性。这样的设计不仅降低了计算成本,还有效提升了选择的精准度。 最后,ECHO机制的应用,使得主干网络能更好地预测未来token。通过复用主干网络的最后一层,模型能够直接针对后续token进行学习,从而提升了生成质量。 作为一款领先的AI工具,文心5.5 Flash Base的发布让我对未来的AI视频工具充满期待。我相信,这样的技术进步,能够为我们带来更多创新的可能性。