在网上找到关于如何将 Claude Code 接入第三方 API 的教程可谓是屈指可数,内容往往也只是教你怎么填充一些基本的参数,比如 `base_url` 和 `api_key`。填完之后能对话就算是完成了。但实际操作一段时间后,你会发现,设置 URL 只是简单的五分钟工作,真正的挑战在于选对平台。
我自己有过类似的经历:最开始我在用 Claude Code 时,选择了官方的额度,但为了省钱,我换成了一家便宜的第三方 API,结果到月底账单不仅没降反而升了。明明单价更低,怎么总账却变了呢?经过反复琢磨,我才意识到一个被我忽视的重要因素——缓存。
今天我想和大家分享一下我在选择 API 平台时的一些经验,尤其是我使用蓝耘的 MaaS 接入 DeepSeek-V3.2 的过程中得出的结论。为了确保数据的准确性,我还对比了另一家平台的同款模型,所有数据都是我亲自通过 curl 命令跑出来的,截图也都准备好了,保证可以复现。
结论先来分享一下,后面的内容会详细论证:
**延迟看尾部,成本看缓存,工具调用看 Agent。**
### 先说说,为什么我最终选择蓝耘而非继续使用官方?
我在选择平台时考虑的事情有几条,按重要性排序如下:
1. 它是否支持 Claude Code 的原生协议,还是需要我自己搭建翻译层;
2. 在同样的操作下,重复上下文是否能命中缓存,从而节省费用;
3. 延迟是否稳定,不要一卡就好几秒;
4. 遇到问题后,是否有地方可以查询使用情况、账单和调用日志。
经过实际测试,蓝耘在这几条标准上都能满足我的需求,尤其是第一和第二点,后面我会提供具体数据来支持我的观点。说实话,蓝耘的模型库相当丰富,DeepSeek、通义 Qwen、智谱 GLM、Kimi、MiniMax等主流模型都在其中,一个 Key 就能调动所有模型,想要更换模型只需改一行配置而已。
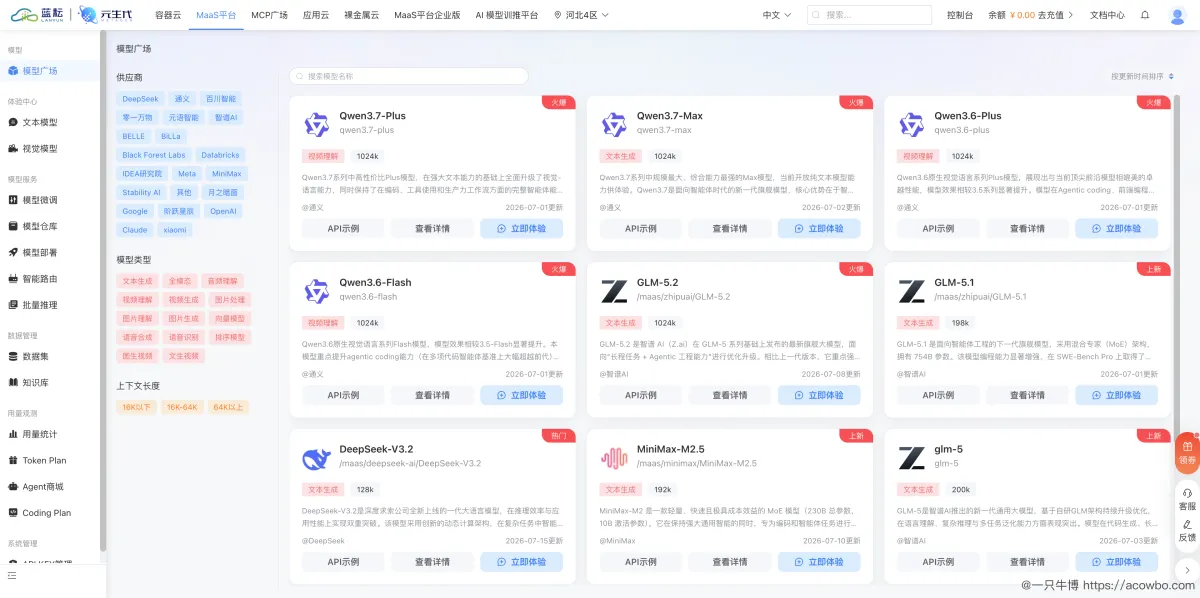
这种“一个 Key 调所有模型”的设计,让我在进行横向对比时省了很多麻烦,不用每个平台注册单独的 Key,选择平台的成本也降低了不少。
### 获取 Key:记住这三件事
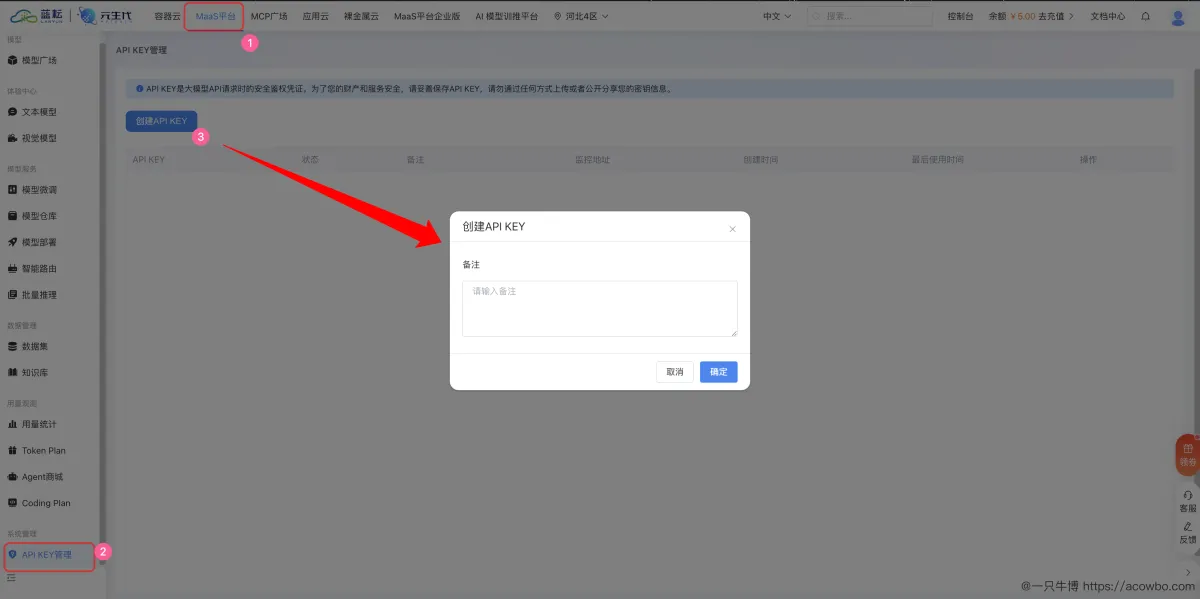
首先,去蓝耘 MaaS 控制台(https://console.lanyun.net/#/register?promoterCode=a1acd000c1)注册并登录,然后充值。这里我踩过一个小坑,没有充值所以一直出现 `invalid company api key` 的错误,充值后再创建 Key 就没问题了。
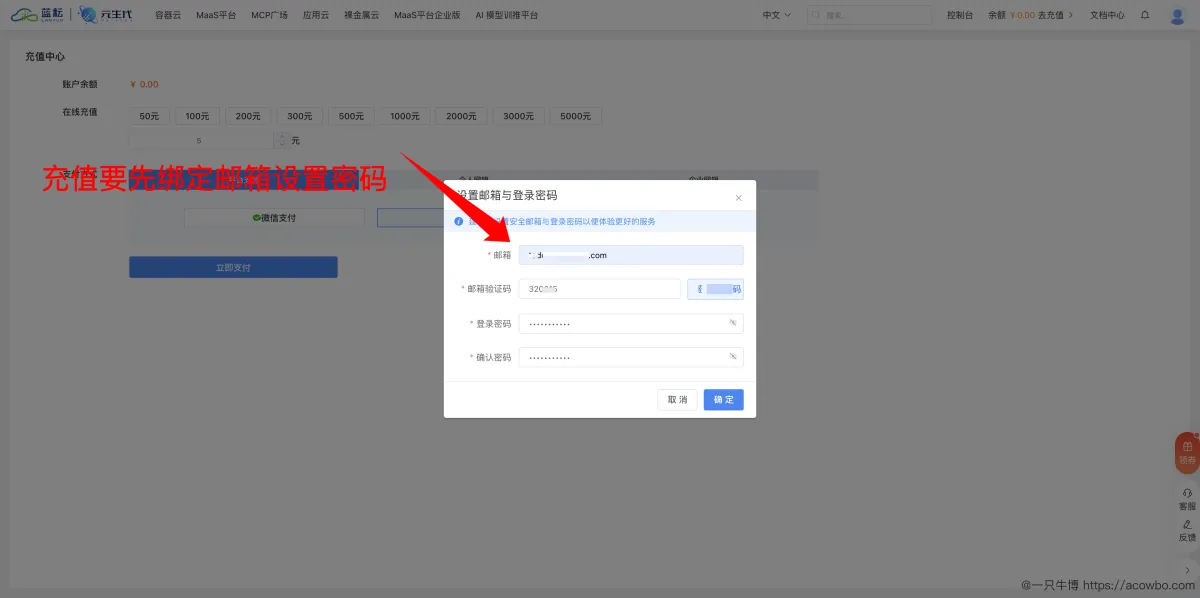
拿到 Key 之后,有三件事你必须确认清楚,这会直接影响后续接入的方式:
1. **调用地址(Base URL)**:`https://maas-api.lanyun.net`
2. **协议格式**:蓝耘提供了 OpenAI 兼容和 Anthropic 兼容的两套端点,这一点非常关键,下面我会单独讲。
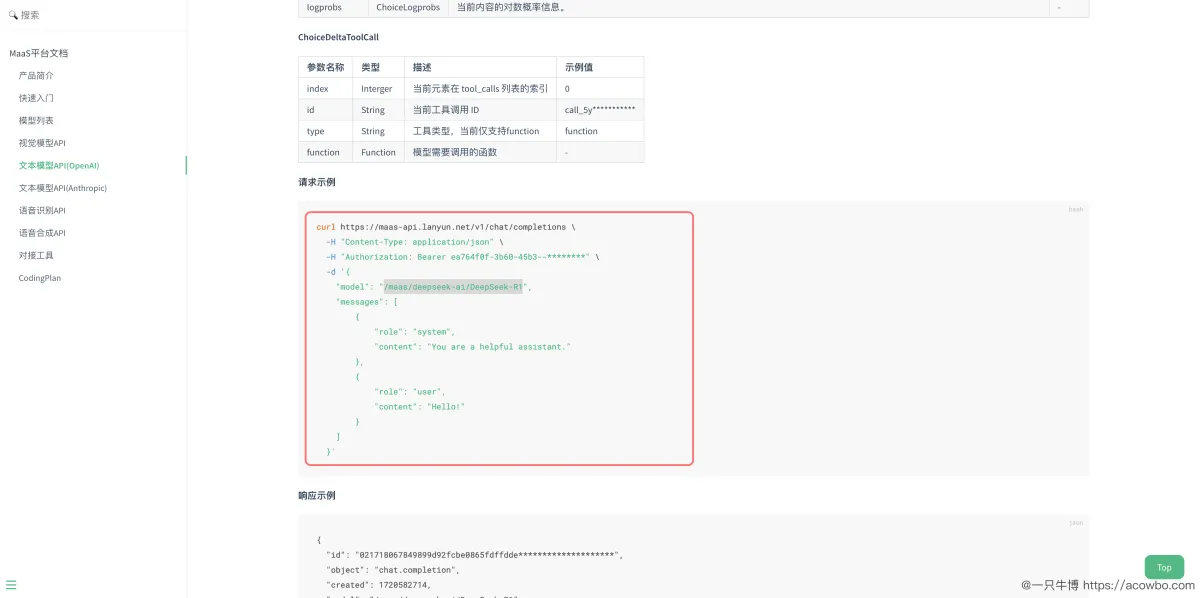
3. **模型的正确调用名称**:例如 DeepSeek 是 `/maas/deepseek-ai/DeepSeek-V3.2`,注意带上 `/maas/` 前缀,别写错了,否则会出现 404 错误。
每个模型在控制台都有 API 示例,照着抄就行,不会出错:
### 第一步:连通性测试,顺便查看使用情况
拿到 API 后,我通常会先发一个最小请求,确认 API 的连通性,别急着写代码。
```bash
export LY_KEY="你的Key" # 请妥善保管
export LY_BASE="https://maas-api.lanyun.net/v1"
export LY_MODEL="/maas/deepseek-ai/DeepSeek-V3.2"
curl -sS "$LY_BASE/chat/completions" \
-H "Authorization: Bearer $LY_KEY" -H "Content-Type: application/json" \
-d "{\"model\":\"$LY_MODEL\",\"messages\":[{\"role\":\"user\",\"content\":\"只回复两个字:通了\"}]}" | jq .
```
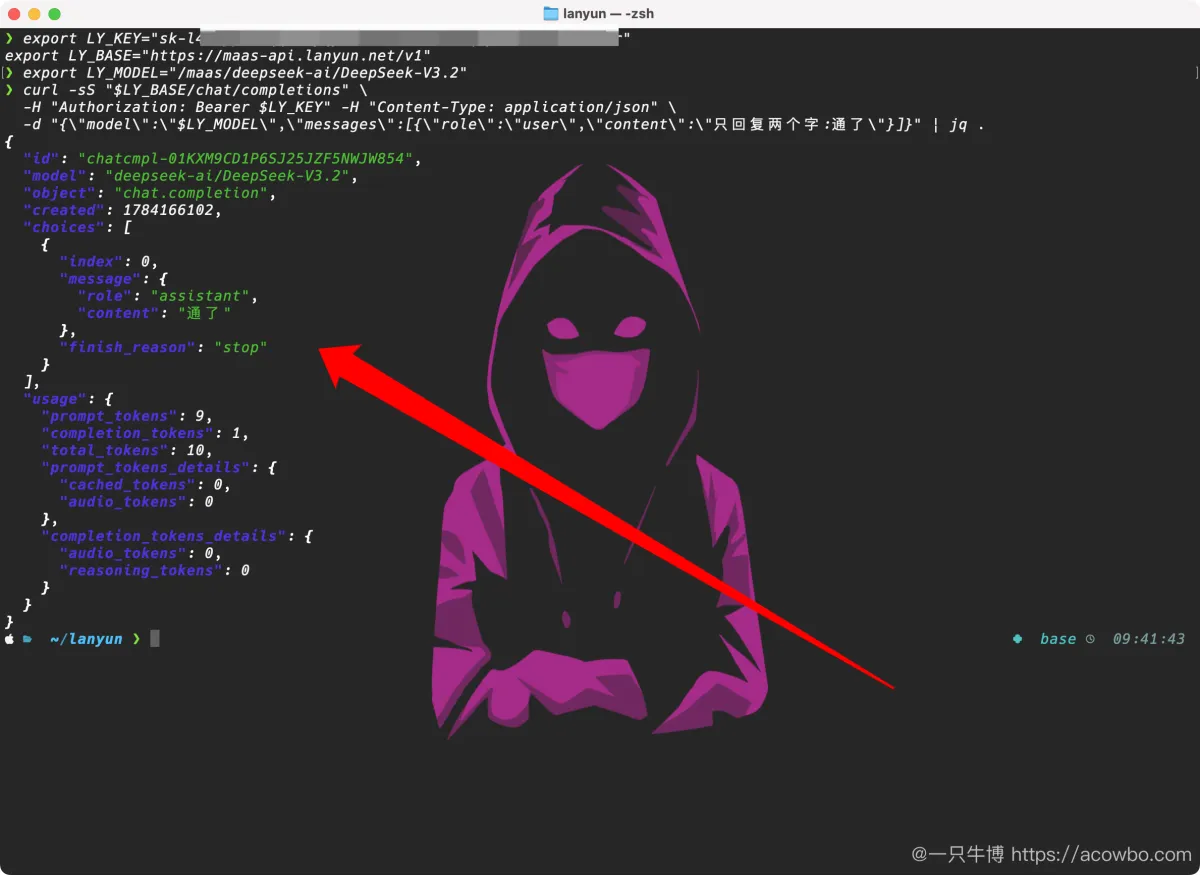
在返回数据中,有个细节我特别留意——`usage` 字段。
```json
"usage": {
"prompt_tokens": 9,
"completion_tokens": 1,
"total_tokens": 10,
"prompt_tokens_details": {
"cached_tokens": 0,
"audio_tokens": 0
}
}
```
这个 `prompt_tokens_details.cached_tokens` 字段的存在,意味着平台透明地告知你缓存命中的 token 数量。很多人只关心返回内容是否正确,而我一定会关注使用情况,这是决定后续能否准确计算成本的关键。现在这里的值是 `0`,我会在后面的部分进一步测试它的变化。
### 第二步:延迟测试——只看平均值的评测都是外行
这是我最想深入探讨的一点。
网上很多关于“某某模型延迟实测”的文章,常常给出一个“平均 1.2 秒”的结果。但对于 Claude Code 这种 Agent 来说, **平均值几乎没用**,你应该关注的是尾部延迟(如 p95/p99)。
原因很简单:Agent 执行任务时,不是发一次请求,而是连续发十几到几十次请求。如果其中有一次延迟到十秒,你的整个任务体验就会崩塌。平均值会掩盖这些偶然的延迟,而你实际感受的,却正是这些突发的延迟时刻。
延迟还得拆分成两个指标来看:
- **TTFT(首 Token 延迟)**:从发送请求到接收到第一个字的时间,决定了任务的响应速度。
- **TPS(吞吐,tokens/秒)**:决定了长输出的等待时间,生成大段内容时会成为瓶颈。
我用相同的 prompt 和请求方式,对蓝耘的 DeepSeek-V3.2 和另一家大厂的同款 DeepSeek-V3.2 各进行了五次连打(同样的模型,不同平台):
```bash
for i in 1 2 3 4 5; do
curl -sS -N -o /dev/null \
-w "#$i TTFT: %{time_starttransfer}s | 总耗时: %{time_total}s\n" \
"$LY_BASE/chat/completions" \
-H "Authorization: Bearer $LY_KEY" -H "Content-Type: application/json" \
-d "{\"model\":\"$LY_MODEL\",\"stream\":true,\"messages\":[{\"role\":\"user\",\"content\":\"用三句话解释什么是KV Cache\"}]}"
done
```
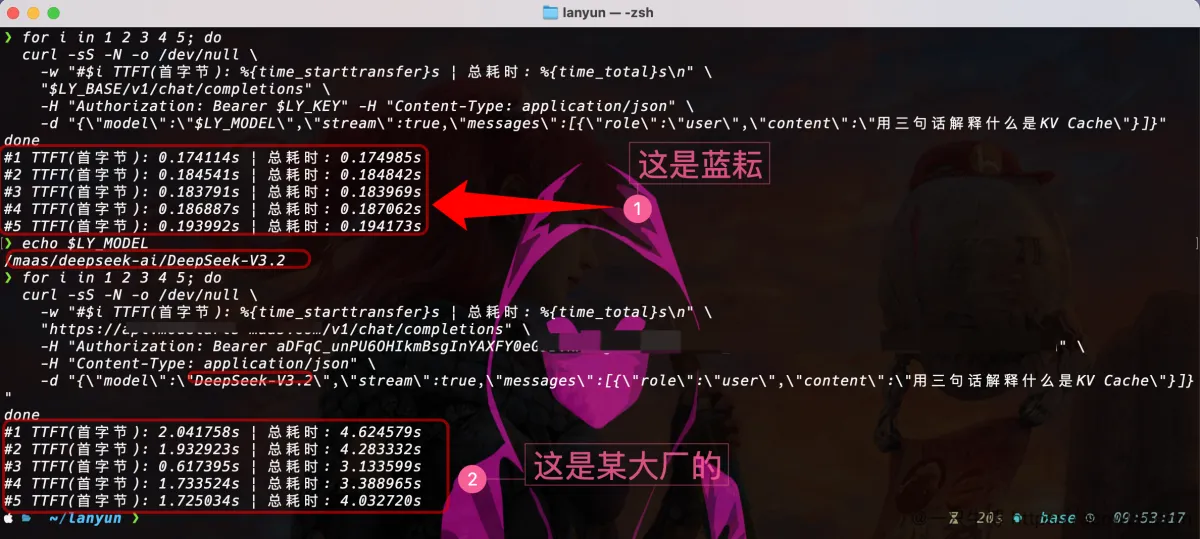
看一下结果:
| 第几次 | 蓝耘 TTFT | 某大厂 TTFT | 某大厂总耗时 |
|---|
| #1 | 0.174s | 2.042s | 4.62s |
| #2 | 0.185s | 1.933s | 4.28s |
| #3 | 0.184s | 0.617s | 3.13s |
| #4 | 0.187s | 1.734s | 3.39s |
| #5 | 0.194s | 1.725s | 4.03s |
这里的关键并不是简单的“蓝耘更快”——快慢受网络和时段影响,不同用户的测量结果可能会有差异。真正值得关注的是,**蓝耘这条链接的延迟方差非常小**。对于 Agent 来说,一个稳定的 200 毫秒的延迟,比一个“平均 800 毫秒但偶尔飙到 2 秒”的链接体验要好得多。这就是“延迟看尾部”的真正含义。
### 第三步:缓存——我上次账单突然暴涨的真正原因
说到这里,我想聊一聊我这篇文章最重要的内容,也是我上次“换得越多,花得越多”的谜底。
Claude Code 这种 Agent 有个特点:**每轮对话都会重新发一大段内容**——包括系统提示、工具定义,以及项目里的上下文,动辄几千到上万 token。你以为你只问了一句“改下这个函数”,实际上发送的数据量可能相当惊人,而且每轮都要这样发。
官方的 Anthropic 支持提示词缓存(Prompt Caching),如果相同的前缀,第一次请求会写入缓存,后续命中的部分只需按照大约十分之一的费用计费。**如果你换的那个第三方 API 不支持缓存,那么每轮请求你都在按照全额的输入付费——成本可能轻松翻五到十倍**。这正是我之前的遭遇:图便宜而选择了不支持缓存的平台,虽然单价低了,但由于没有缓存的支撑,总账单反而涨了。
因此,选择平台时,缓存的支持与否,对明显的 Agent 场景是**至关重要**的。光看单价的“元/百万 token”根本不够,还得考虑它是否计算缓存费用。
我怎么验证的呢?我构造了一个大的系统上下文(约 6000 token),然后用**完全相同**的请求连续发送两次——注意,完全一样,因为缓存是通过前缀匹配的,改一个字可能就导致不命中:
```bash
# 造一个约 6000 token 的大 system 上下文
BIG=$(python3 -c "print('你是一个资深工程师。以下是项目规范:'+ '规则条目。'*2000)")
# 连发两次完全相同的请求,盯 cached_tokens 的变化
for round in 1 2; do
echo "=== 第 $round 次 ==="
curl -sS "$LY_BASE/chat/completions" \
-H "Authorization: Bearer $LY_KEY" -H "Content-Type: application/json" \
-d "$(jq -n --arg m "$LY_MODEL" --arg s "$BIG" \
'{model:$m,messages:[{role:"system",content:$s},{role:"user",content:"回复ok"}]}')" \
| jq '.usage.prompt_tokens, .usage.prompt_tokens_details.cached_tokens'
sleep 2
done
```
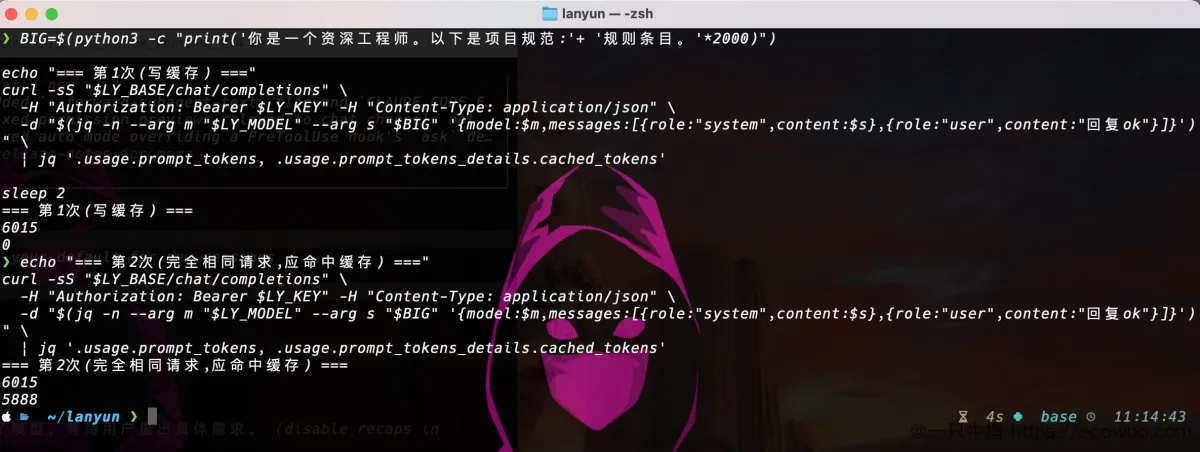
结果非常明显:
| prompt_tokens | cached_tokens | 命中率 |
|---|
| 第 1 次 | 6015 | 0 | 写缓存 |
| 第 2 次 | 6015 | **5888** | **97.9%** |
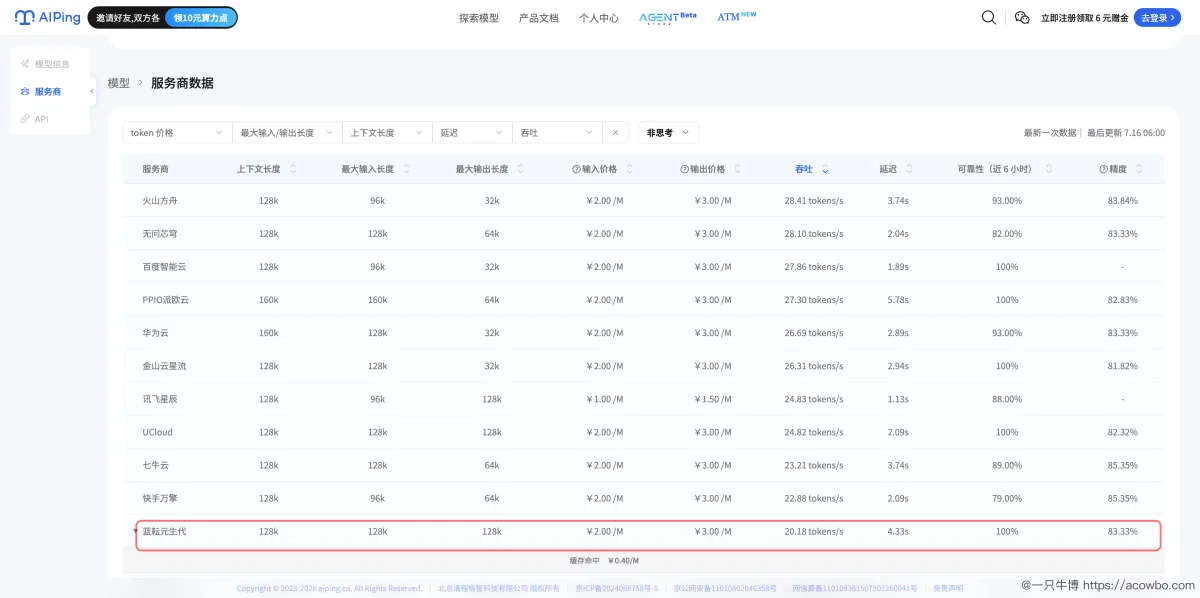
用人话说,Claude Code 在这种“每轮重发大 prompt”的场景里,从第二轮开始,你的输入成本中近 98% 的部分都能走缓存价。DeepSeek-V3.2 在蓝耘上的定价是输入 2 元/百万 token,而根据数据,蓝耘的**缓存命中价只有 0.40 元/百万 token**——也就是原价的两成。
算一笔账你就会明白差距了。假设一个任务需要运行 20 轮,每轮都要重发 6000 token 的上下文:
- 不走缓存:20 × 6000 × 2元/M = 约 0.24 元
- 走缓存(第二轮开始):20 × 6000 × 0.40元/M = 约 0.048 元
这样一对比,差距一下子就显现出来了。
总的来说,选择第三方 API 的时候,延迟、缓存支持是两个非常重要的因素,尤其在实际使用中,合理的选择能够节省不少的成本和提升使用体验。希望我的分享能对你有所帮助!
 优推编辑部