 优推编辑部
过去几年,AI的发展离不开大量的数据支持。无论是大语言模型借助互联网积累的网页和代码数据进行训练,还是特斯拉通过数百万辆量产车采集真实行驶数据,这些都为技术进步奠定了基础。
但说到具身智能领域,情况就不太一样了。
过去两年,行业主要依靠真机遥操作和第一视角(EGO)可穿戴设备来获取数据。然而,最终获得的有效数据也只有几百万小时。对于已经投入巨额资金的机器人企业来说,获取足够规模的高质量训练数据依然是个大挑战。
就在10月30日,空间智能公司影溯(InSpatio)在杭州开设了全国首个具身仿真数据采集中心,计划每月生产100万小时的仿真训练数据,而每条数据的综合成本仅为传统真机遥操作采集的1/10。
影溯是如何做到的呢?我们得先理解一下现在具身智能在数据采集方面遇到的挑战,以及他们是如何将现实场景转化为机器人训练数据的。
一、 为什么当前的具身行业无法实现大规模数据供给?
合格的具身Token需要三个关键要素:三维空间观测、真实物理接触反馈和可执行动作序列。
换句话说,数据不仅要记录机器人看到的内容,还要包括机器人与物体的互动及其后果。目前,这个行业主要依赖两条数据获取路径:一是通过真机和可穿戴设备在物理世界采集,二是通过三维建模和物理仿真在数字世界生成数据。但这两条路径都开始面临效率瓶颈。
1. 物理现场采集:时间、环境和场地限制
真机遥操作是获取机器人动作数据的主要方式之一,但效率相对较低。一个操作员控制机器人工作一小时,实际上有效采集的轨迹可能不到半小时。想要扩大数据规模就得增加设备和操作人员,这样一来,采集效率就受到了很大的限制。
为了降低成本,一些团队开始使用EGO第一视角的穿戴设备进行数据采集。这种方式依赖于真实环境,但也有不少限制。比如,环境的调整不够灵活,想要测试不同的场景条件,就得重新进入现场,费时又费力。
而且,许多真实场地,比如正在营业的商超和工厂,外部团队根本不允许随意改动,就算发现了问题也无法返回复现。再加上有些高危场所以及私人住宅,还对外部设备进出有严格的限制。
2. 数字世界的产能限制:场景建模效率问题
与真实环境采集相比,仿真平台可以在虚拟环境中调整场景,减少对真机的依赖。但问题是,仿真平台本身并不能直接提供训练数据,必须先解决场景建模的效率问题。
就拿Isaac Sim这样的物理仿真引擎来说,虽然它能模拟机器人运行和物理交互,但建房、物体建模、设置碰撞边界等依然需要人工来完成,成本和时间都不小。
那么,能不能让大模型直接完成建模呢?最近一些模型开始尝试,但实际应用中还有很多问题。例如,生成一个物体可能需要几十分钟,一个完整的场景甚至需要几小时。这样不仅效率低下,生成的场景也可能显得不够真实。
所以说,无论是物理数据采集还是数字数据生成,业界都面临着各自的挑战。这让具身数据的规模化生产成了一道难以跨越的鸿沟。
二、 影溯如何打破困局:用工业流水线逻辑建造具身Token工厂
在AI算力中心被称为“Token工厂”的同时,影溯的具身仿真数据采集中心也采用了类似的思路。通过自研的Topos空间智能底座,他们将现实空间转化为可交互的数字场景,再用于生成机器人训练数据。这一过程被拆分为三条全自动工业产线:
1. 上游场景入厂:15分钟将真实场景搬进云端
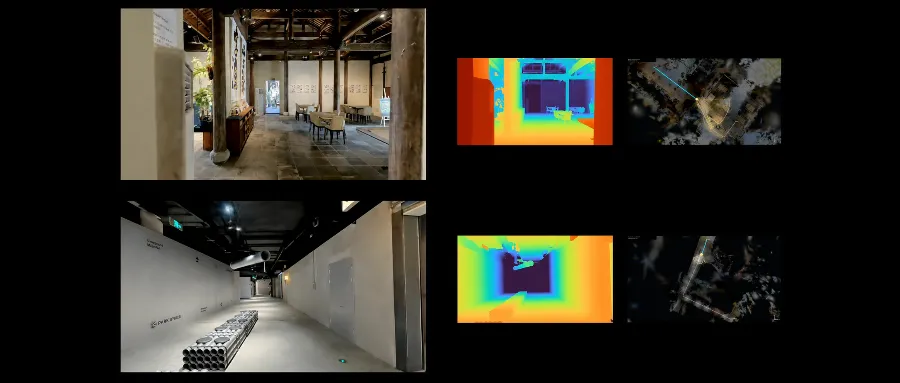
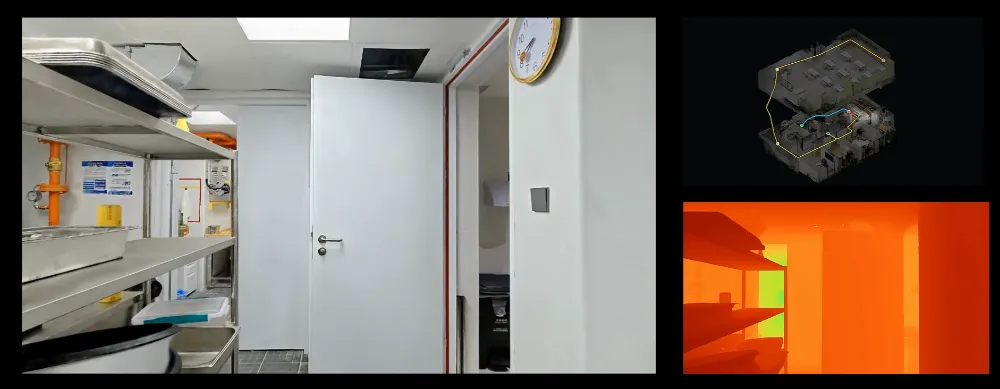
影溯针对上面提到的问题,采用了多源轻量输入与原生3D生成的方式进行场景采集。对于能够进入的场地,影溯使用便携设备进行扫描,短短15分钟就能采集上百平方米的空间。而对于不能进入的场合,他们则采用现场人员拍摄的多视角视频或照片,或是通过原生3D场景生成。
原始数据进入Topos引擎后,系统通过算法完成三个步骤:
第一步,物体拆解。系统会自动识别可操作的物体,并将它们从背景中剥离,解决普通三维扫描中物体与场景粘连的问题。
第二步,盲区补全。系统会填补相机拍摄不到的区域,生成完整的三维模型。
第三步,物理标定。为物体生成碰撞边界和物理属性,使其能够直接进入物理仿真器。
经过这些处理,像住宅、商超、餐厅等场景都可以转化为可运行的数字环境。影溯表示,完成扫描后,相关场景可以在几小时内完成转换。
这样一来,经过数字化处理后,同一场景可以在仿真环境中反复使用,也可以调整物体位置和环境条件,生成不同的训练场景。
2. 中游算力扩展:云端的受控调整与并行合成
一旦真实场景转化为可编辑的数字模型,EGO和真机采集的环境调整难题就都迎刃而解。
在影溯的生产线上,一个真实场景入库后可以反复调用。当需要增加环境变化时,系统可以直接调整数字场景的参数。之后,只需引入少量真实示范动作作为种子,就能在云端启动多个仿真通道,并行规划和执行动作。
底层物理引擎负责实时计算操作产生的力学结果,最终批量生成具身Token,数据的产量将更多取决于数字场景的复用程度和云端并行算力。
3. 下游品控与闭环:定向补齐数据
数据规模扩大后,如何避免重复采集、确保数据有效性,成了影溯面临的一大挑战。
影溯为场景设置了去重标准,确保每个场景都是完整的,不会重复统计。数据交付时,按照空间几何、物理交互和任务评测进行分级供给。
与此同时,数据生产还与下游模型评测形成了闭环。当客户模型在测试中暴露出短板时,影溯可以迅速生成符合条件的新数据,帮助模型优化,不必重新回访现场。
结语:将物理空间转化为原材料,具身智能需要新的Scaling Law
语言模型能沿着Scaling Law快速提升,得益于互联网将文本数据数字化。而机器人走出实验室走向千差万别的真实世界,始终面临数据转化的难题。
当大多数团队还在通过增加设备和人手来积累数据时,影溯给出了新解法:把物理空间视为原材料,通过三维重建和并行仿真,构建一座全天候运转的具身Token工厂。
当百小时级别的物理交互数据能够像工业产品一样按月生产,具身智能的大规模训练才能建立稳定的数据基础。